メガトレンド · 人工知能
NVIDIA はAIチップを「設計」できる。でも「作る」ことはできない——AI時代の本当のボトルネックは、デザインではなく、それを組み立てられるたった一つの工場
AIチップは一発のプリントで生まれるわけではありません——一個のGPUのまわりに、HBMという何本ものメモリを極限まで近づけて並べ、interposer と呼ばれる小さなシリコン板の上に載せて、一つのパッケージに組み上げる。この工程の名前が CoWoS で、世界でこのレベルをこなせる工場はただ一つ、TSMC だけ。いまAIチップの需要が詰まっているのは、NVIDIA のデザインではなく、TSMC が CoWoS を作りきれないからなんです。このレッスンでは、いちばん深い層をのぞきにいきます——誰がAIチップを「製造」し「組み立て」ているのか、そしてなぜ組み立て能力こそがAIブーム全体の本当のボトルネックなのか。
01これは何?——AIチップの製造工場と組み立て工場
「NVIDIA がAIチップを作っている」という言い方は、ちょっとズレています——NVIDIA はチップを設計するけれど、自前の製造工場は持っていません。こういう会社を「fabless(工場を持たない)」と呼びます。NVIDIA が送ってきた設計どおりに、実際にチップを「作る」のは、受託製造の工場、つまりfoundryです。この node が扱うのは、AIチップのサプライチェーンでいちばん奥にある二つの仕事です:(1) 製造(foundry)——シリコンの上にトランジスタを刻む工程、そして(2) 先端の組み立て(advanced packaging)——複数の部品を一つのパッケージに組み上げる工程。
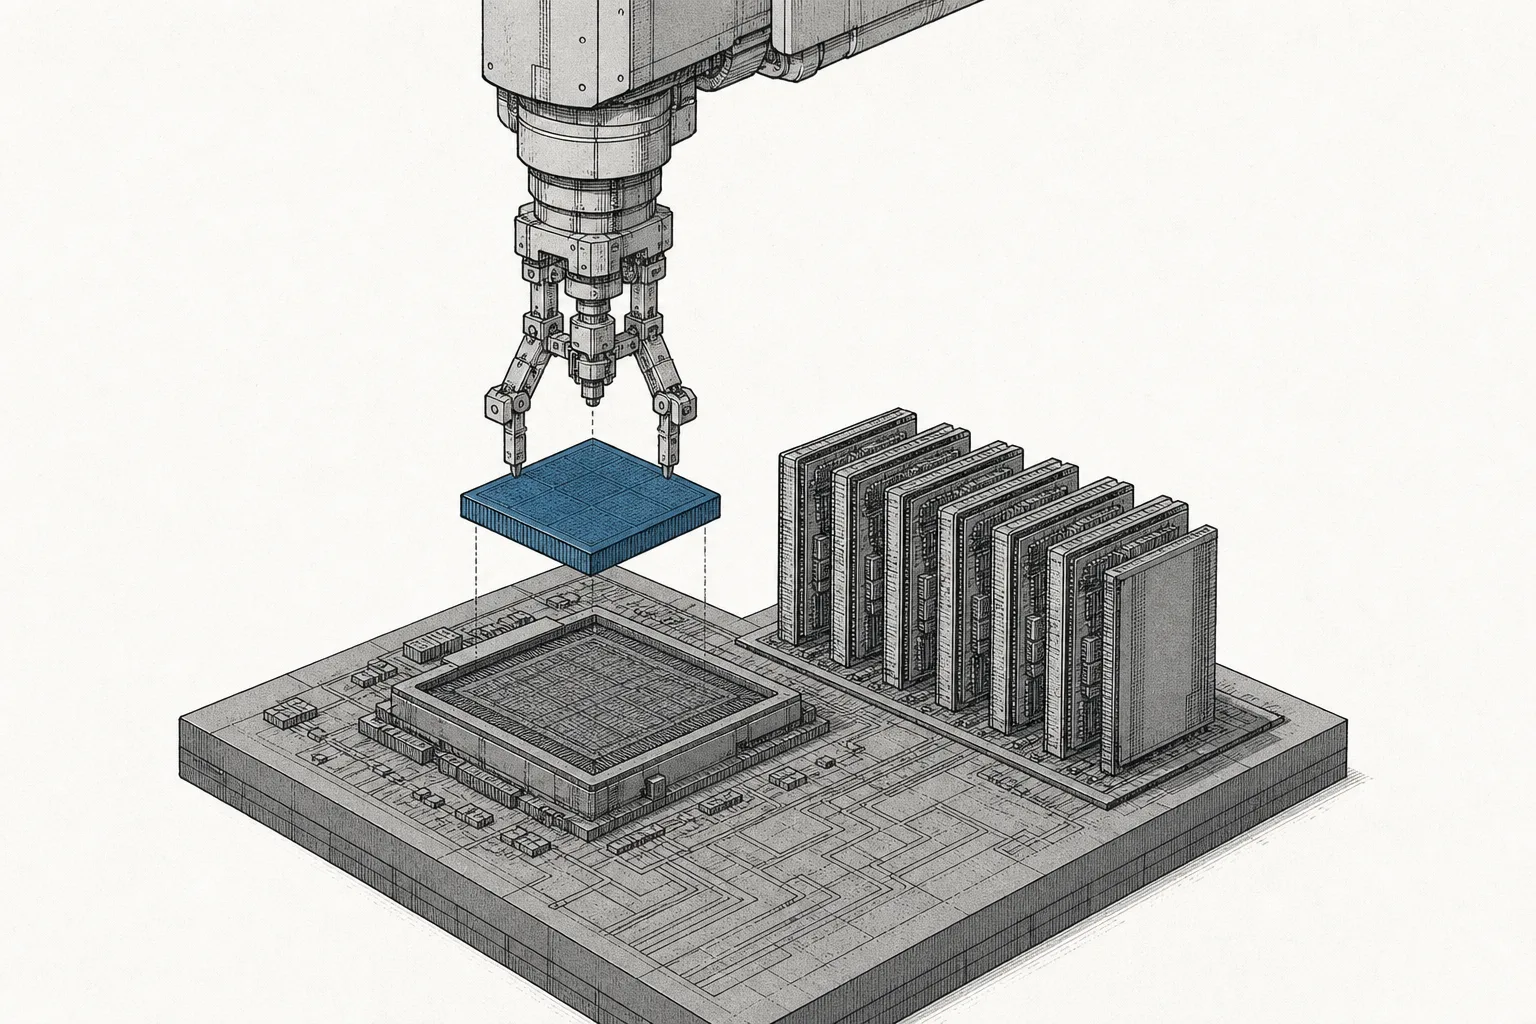
なぜ二つの仕事に分かれるのか?それは、いまどきのAIチップが、もう一枚のシリコンの塊ではないからです。いまのAIチップは「複数の部品を組み合わせたチップ」——真ん中に計算の頭脳である GPU があり、そのまわりをHBMという何本ものメモリが取り囲む。データを間に合わせて送り込むために、これらをぎりぎりまで近づけて並べる必要があります。すべては薄いシリコン板の上に載っていて、その板が「配線の橋」となってすべての部品をつなぎます。これらの部品を組み合わせて一つとして動くようにするのが「advanced packaging」で、TSMC のいちばん有名な技術がCoWoSです。真ん中の計算チップがGPUでも、テック大手の専用設計チップ(ASIC)でも、この組み立てを同じように通る必要があります。
メガトレンドの地図で見ると、この node は大トレンドArtificial Intelligenceの中のAI Compute & Accelerator Siliconの下にある枝(leaf)です。もし兄弟にあたるGPUやHBMが「部品」だとすれば、この node はその部品そのものを作り、組み合わせる人——AIチップ一個が工場を出る前の、最後の関所です。
Foundry=チップの受託製造工場。顧客が設計したとおりに、ウエハーの上にトランジスタを作る(TSMC が世界一)· Advanced packaging=一つずつ載せるのではなく、複数のチップを一つのパッケージに組み合わせること。部品どうしを近づけて、より速く通信できるようにする · CoWoS(Chip-on-Wafer-on-Substrate)=GPU と HBM を中間のシリコン板(interposer)に載せて、AIチップ一個に組み上げる、TSMC の advanced packaging 技術。
02なぜ重要か——CoWoS こそがAIの本当のボトルネック
よくある誤解があります:AIチップをもっと欲しければ、NVIDIA にもっと設計させればいい、と思いがち。でも本当はこうです——NVIDIA はいくらでも設計できる。間に合わないのは、それを「作る」ことと「組み立てる」ことのほう。そしていちばん詰まっているのはトランジスタの製造(TSMC はわりと間に合っている)ではなく、最後の組み立て——CoWoSなんです。
理由はこうです。AIチップ一個には、GPU を、通常より何倍も大きい interposer の上に何本もの HBM と並べて載せる必要があります。この作業は繊細で遅く、月に作れる量も少ない。だから TSMC が「本物の蛇口」になっているのです——2024年末、TSMC の CoWoS 生産能力はおよそ月35,000枚のウエハー、2025年末に月〜75,000枚へと加速し、2026年末には月〜125,000〜130,000枚を目標にしています——2年足らずでほぼ4倍。それでも足りない。TSMC の経営陣自身が、CoWoS の生産能力は「非常に逼迫していて、2026年まで予約で埋まっている」と語っています。先端の組み立て工場全体も2027年まで予約で埋まり、順番待ちは52〜78週に及びます。
それに劣らず大事なのが、最先端の製造が一社に集中していること。2026年、TSMC はAIチップが必要とする最先端ノード(advanced node)の製造市場の90%以上を握ります——つまり世界中のトップクラスのAIチップは、NVIDIA だろうと AMD、Google、Amazon だろうと、ほぼすべて TSMC 一社で作られているということ。そしてAIが最先端の生産能力を大量に吸い込んでいるため、高性能計算(HPC、AIチップを含む)からの売上が2025年には TSMC 全体の売上の58%にまで跳ね上がり、2026年には60%を超える見込みです。
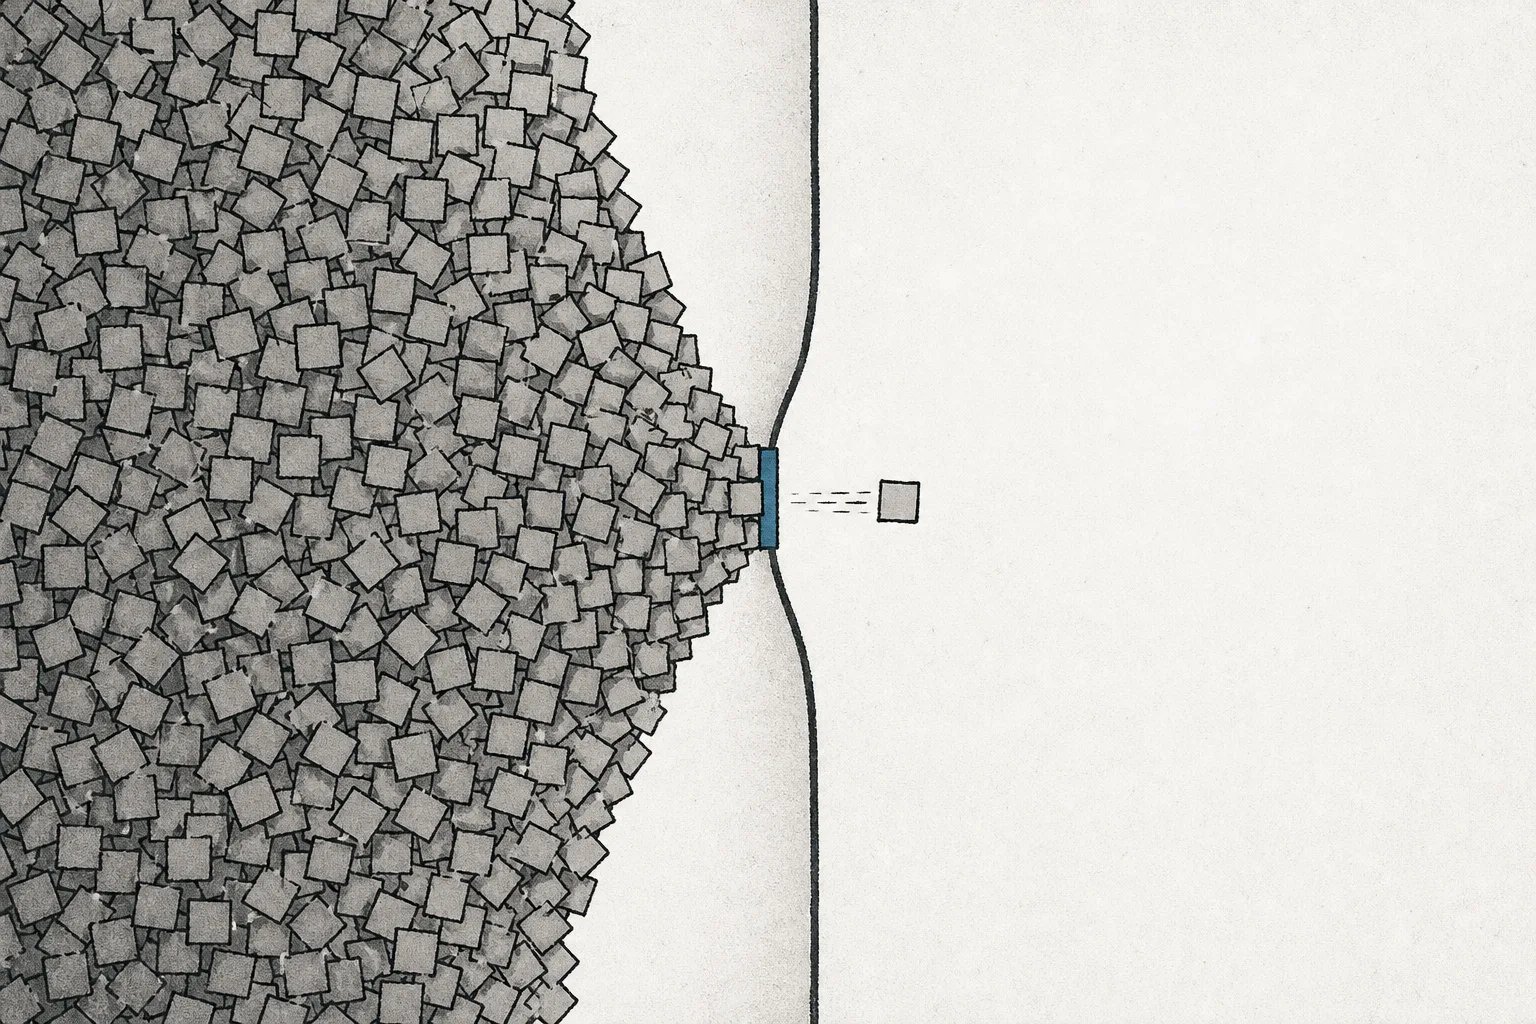
これがこの node が静かに、しかし強力に重要である理由です:需要があふれているのにAIチップが「品薄」なのはなぜか——それを理解したい人は、必ずこの層を見なければなりません。なぜならボトルネックは作って組み立てる能力にあって、アイデアや設計にあるのではないからです。
03どう動くのか——GPU + HBM から一つのパッケージへ
advanced packaging の核心は、シンプルな問いです:どうやって GPU とメモリ HBM をできるかぎり近づけるか。近ければ近いほど、データは速く流れ、電力も節約できるからです。もし HBM を普通のパソコンのように基板(PCB)の上で遠くに離して置けば、帯域幅がガクッと落ちて GPU が本来の力を出しきれません。TSMC の答えが CoWoS です——AIチップ一個がどう組み上がるのか、一段ずつ追ってみましょう。
真ん中の interposer こそ、見えない主役です。これは高密度の配線と「through-silicon via」(TSV)という貫通孔を持つ薄いシリコンで、GPU が HBM と毎秒数テラビットという速さで会話できるようにします——普通の基板を通すよりも何倍も速い。問題は、AIチップの interposer がどんどん大きくなっている(標準のウエハーサイズを何倍も超える)こと。大きいほど作るのが難しく、不良も出やすい——これが CoWoS がボトルネックになる技術的な理由です。
CoWoS は「2.5D」という組み立て方です——部品を interposer の上に横並びに置く(重ねない)。次の段階が3D——チップを直接重ねて、原子レベルの「ハイブリッドボンディング(hybrid bonding)」でつなぐ。TSMC の 3D 技術の名前がSoIC(System on Integrated Chips)で、部品をさらに近づけ、速度と密度をともに高めます——これが新世代のAIチップが向かっている方向です。
04エコシステムのどこにいるのか
AIチップの層全体を一本の製造ラインと見れば、この node はすべての部品が合流する終着点——設計が現実のモノになる関所です。隣り合う node とは切り離せないほど密につながっています。
- GPUをHBMと組み合わせる: この二つが CoWoS が組み合わせる主な材料です。どちらか一つでも欠ければ——GPU が足りないか、HBM が足りないか——組み立てラインは止まる。だから CoWoS のボトルネック、HBM のボトルネック、GPU のボトルネックは、もつれ合った一つの問題なんです
- FoundryとAdvanced PackagingのAIの切り口: チップ業界の製造と組み立てには色々な客がいますが、いまいちばん速く成長し、いちばん高く払うのがAI。だから HPC が TSMC の売上の58%にまでなった——この node は、その二つの話の「AI支店」をSemiconductorsトレンドの中で担っています
- Energy Transition & Powerから力を吸う: foundry と packaging の工場は膨大な電力と水を消費する。生産能力の拡大は、各地域の電力網の準備状況に直接ひもづいています
- Critical Materials & Supply Chainに頼る: 先端の組み立てには高品質の基板、特殊な化学品、希少な材料が要る——だからこの node は、世界の原材料サプライチェーンの緊張に敏感です
05いま、どこまで来たのか
いまの姿は一文でまとめられます:TSMC が最先端AIチップの製造も組み立ても、ほぼ独占的に握っている。2025年末、TSMC は2ナノメートル(2nm)級のチップを良好な歩留まりで量産し始め、CoWoS の組み立て能力を継続的に加速させています。いちばん大きな客はNVIDIA で、2025年の CoWoS-L の組み立て能力をすでに70%以上予約済み——Blackwell チップを供給するためです。残りは AMD、Broadcom、Marvell などで分け合っています。
ライバルも追いつこうとしていますが、まだそれなりに差があります。Intelは自前の foundry 工場で 18A チップの歩留まりを60%超まで引き上げ、社外の客もちらほら取り始めました。いっぽう、長らく最先端製造の2番手だったSamsungは 2nm チップの歩留まりでつまずいています(40%を下回ると見られている)——AIチップ製造の1位と2位の差は、まだ大きいままです。
組み立ての面では、CoWoS を自前で手がける TSMC のほかに、OSATと呼ばれる受託の組み立て・検査工場のグループがあり、2025年に advanced packaging 市場のおよそ59%を占めました。先頭を走るのがASE(世界一)とAmkor(2番手、シェア約15%、2024年の売上は約63億ドル)——両社とも TSMC が手が回らない、あるいは自前でやらない組み立てを引き受け、AIの波に乗るために先端の組み立て能力を拡大しています。
06これからの展開
第一の方向は組み立て能力を全力で拡大すること。CoWoS がボトルネックであるかぎり、TSMC とライバルは新しい組み立て工場の建設にお金を注ぎ続けます——2026年末に月〜125,000〜130,000枚という目標は、2年でほぼ4倍。これがこの node の構造的な追い風です:AIチップの需要があふれているかぎり、組み立て能力をいくら増やしても、その分だけ予約で埋まっていくのです。
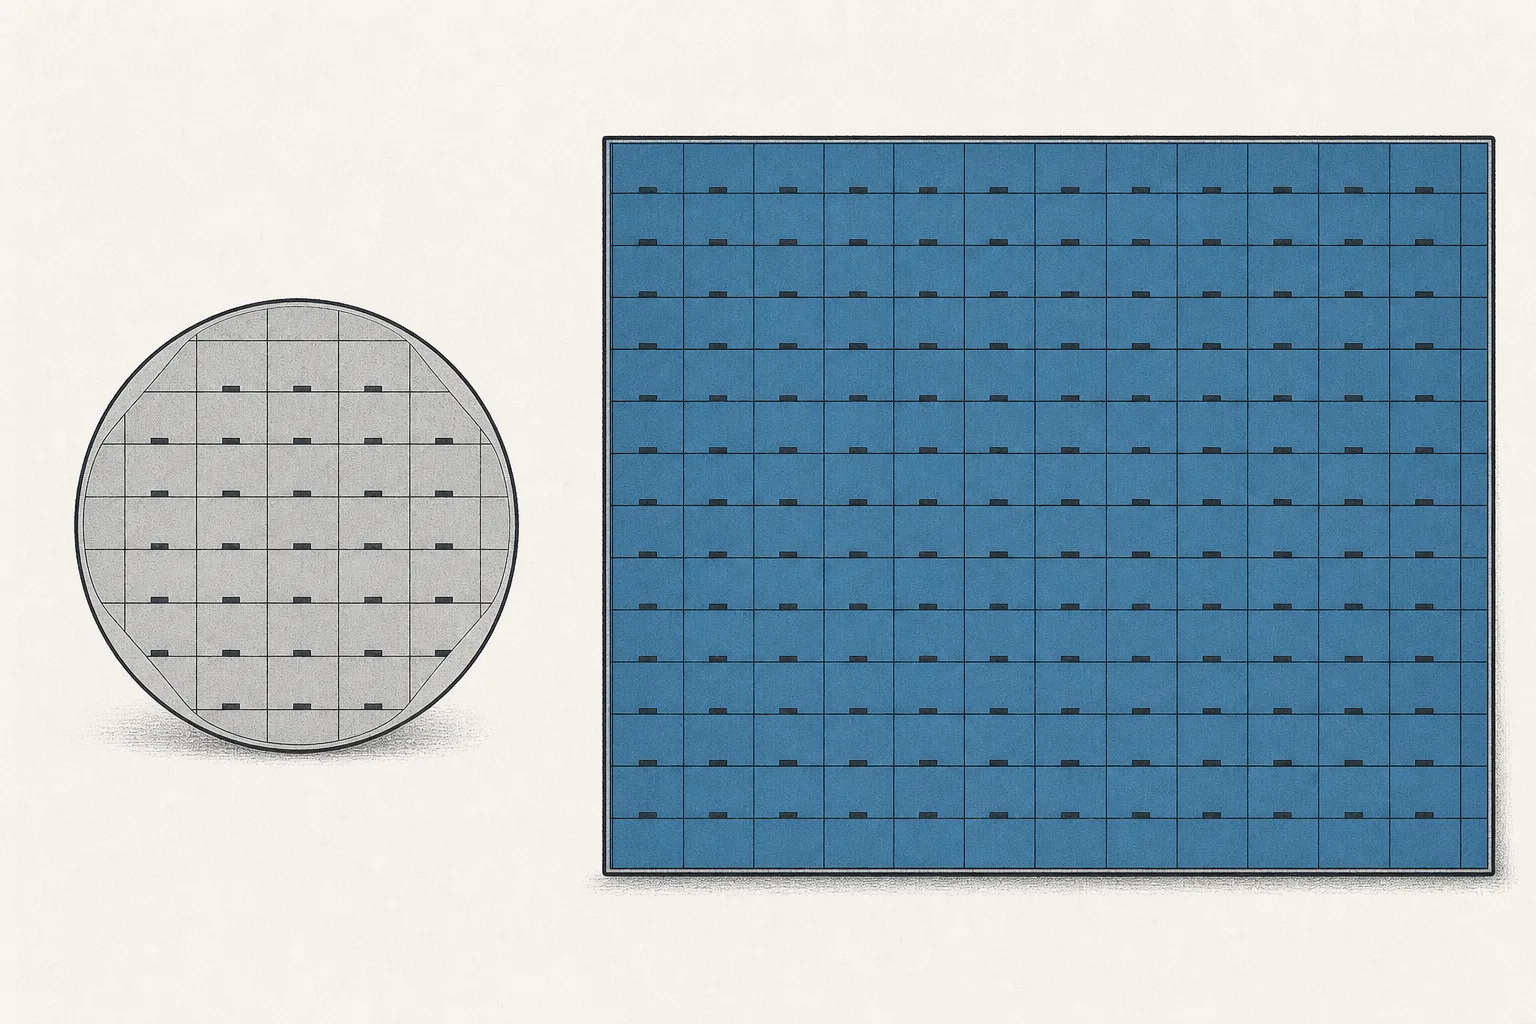
第二の方向は丸いウエハーから四角い板へ(panel-level packaging)。いまの組み立ては丸いウエハーの上で行うため、縁の捨てる部分が多く、サイズにも限りがあります。これから業界は、大きな四角い板(ディスプレイのような)の上での組み立てへと移っていきます——一度に多くの部品を組み立てられ、より大きなAIチップにも対応できるからです。ただし、1ライン5億ドルを超える新しい製造ラインへの投資が必要です。
第三の方向は新しい材料——ガラス基板(glass substrate)と 3D の接合。ガラス基板は従来の材料より平らで耐熱性が高く、大きなチップをより精密に組み立てられます。いっぽう 3D のチップ積層(SoIC, hybrid bonding)は、GPU とメモリをこれまで以上に近づけます——この二つは、これから数年のAIチップを定義する「次の世代」の組み立てです。
07課題とリスク
第一のリスクは台湾への集中です。最先端AIチップの90%以上が、製造拠点を主に台湾に置く TSMC によって作られ組み立てられている以上、地政学リスクや自然災害は他人事ではありません。もしこの一点がつまずけば、世界中のAIチップのサプライチェーンが即座に揺らぐ。TSMC は米国に工場を建てることでリスクを分散しようとしています(アリゾナ州に総額1,650億ドルもの投資)が、先端の組み立て能力までを移すには何年もかかります。
第二のリスクは需要に追いつかない組み立てのボトルネックです。TSMC が CoWoS をほぼ4倍に拡大しても、多くのアナリストは、より速く伸びる需要には足りないかもしれないと見ています。結果としてAIチップは品薄が続き、値段は高く、小さな客は大手に順番を譲らされる——このボトルネックが、誰がAIチップを先に手に入れるかを決めてしまうのです。
第三のリスクは少数の客と取引先への依存です。NVIDIA が組み立て能力の70%以上を予約している以上、この層の売上は、ふところの深い少数の客のAI投資にひもづきます。もしAI投資が減速したり、果てしなく見えた需要が満ち始めたりすれば、巨額を投じて作ったばかりの組み立て能力が、一夜にして余ってしまうかもしれない——利益率はいいけれど、変動する投資サイクルに縛られたビジネスなのです。
ひとことで言えば:この node は、多くの人が見過ごす問い——「AIチップを本当に作っているのは誰か?」——への答えです。答えは NVIDIA ではなく、TSMC と、GPU と HBM を一つに組み上げるごく少数の組み立て工場。CoWoS の組み立てが、いちばん遅くていちばん不足する場所であるかぎり、この層はAI経済全体で最も強力なボトルネックの一つであり続けます。