Megatrend · Artificial Intelligence
NVIDIA ออกแบบชิป AI ได้ แต่ “สร้าง” ไม่ได้ — คอขวดจริงของยุค AI ไม่ใช่ดีไซน์ แต่คือโรงงานเดียวที่ประกอบมันได้
ชิป AI หนึ่งตัวไม่ได้เกิดจากการพิมพ์ครั้งเดียว — มันคือ GPU หนึ่งก้อนที่ต้องเอาหน่วยความจำ HBM หลายแท่งมาวางชิดกันบนแผ่นซิลิคอนเล็กๆ ที่เรียกว่า interposer แล้วประกอบเป็นแพ็กเกจเดียว ขั้นตอนนี้ชื่อ CoWoS และมีโรงงานเดียวในโลกที่ทำได้ระดับนั้นคือ TSMC ทุกวันนี้ดีมานด์ชิป AI ไม่ได้ติดที่ดีไซน์ของ NVIDIA แต่ติดที่ TSMC สร้าง CoWoS ไม่ทัน บทเรียนนี้พาไปดูชั้นที่ลึกที่สุด — ใคร “ผลิต” และ “ประกอบ” ชิป AI จริงๆ และทำไมกำลังการประกอบจึงเป็นคอขวดที่แท้จริงของบูม AI ทั้งใบ
01มันคืออะไร — โรงผลิตและโรงประกอบชิป AI
เวลาเราพูดว่า “NVIDIA ทำชิป AI” มันคลาดเคลื่อนนิดหนึ่ง — NVIDIA ออกแบบ ชิป แต่ไม่ได้มีโรงงานผลิตของตัวเอง บริษัทแบบนี้เรียกว่า “fabless” (ไม่มีโรงงาน) ส่วนคนที่ลงมือ “สร้าง” ชิปจริงๆ ตามแบบที่ NVIDIA ส่งมา คือโรงงานรับจ้างผลิตที่เรียกว่า foundry node นี้คือเรื่องของสองงานที่อยู่ลึกสุดของห่วงโซ่ชิป AI: (1) การผลิต (foundry) — แกะสลักทรานซิสเตอร์ลงบนแผ่นซิลิคอน และ (2) การประกอบขั้นสูง (advanced packaging) — เอาชิ้นส่วนหลายก้อนมาประกอบเป็นแพ็กเกจเดียว
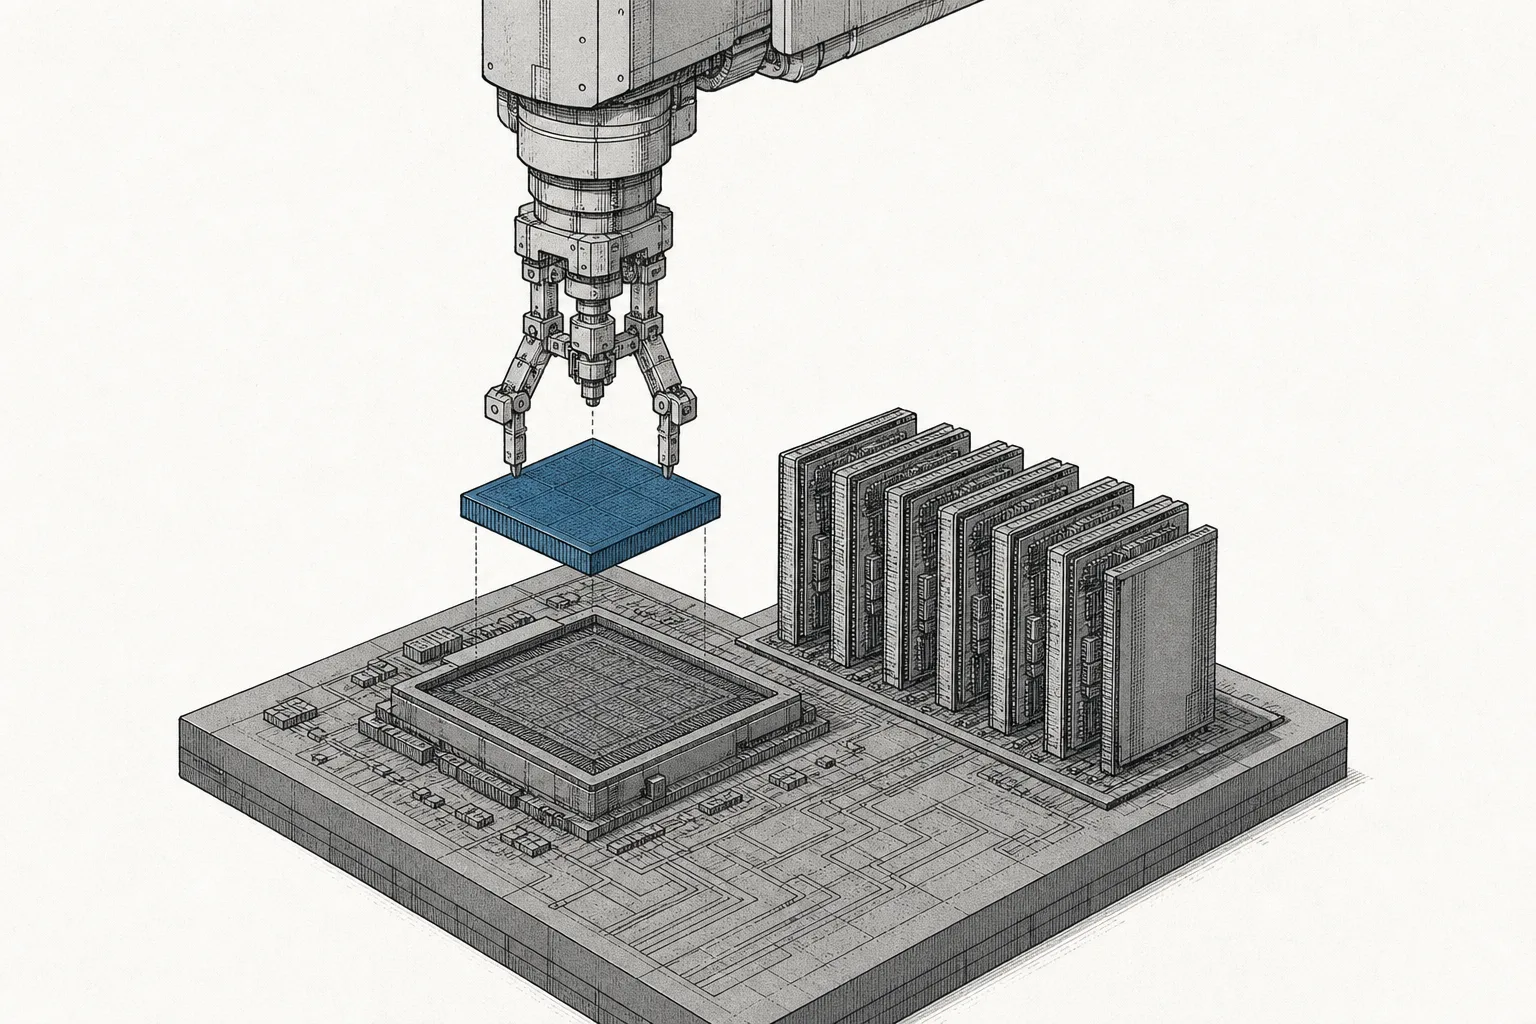
ทำไมต้องแยกเป็นสองงาน? เพราะชิป AI สมัยใหม่ไม่ใช่ซิลิคอนก้อนเดียวอีกต่อไป มันคือ “ชิปประกอบจากหลายชิ้น” — มี GPU (สมองคำนวณ) อยู่ตรงกลาง ล้อมด้วยแท่งหน่วยความจำ HBM หลายแท่งที่ต้องวางชิดกันมากๆ เพื่อป้อนข้อมูลให้ทัน ทั้งหมดนี้วางอยู่บนแผ่นซิลิคอนบางๆ ที่ทำหน้าที่เป็น “สะพานสายไฟ” เชื่อมทุกชิ้นเข้าด้วยกัน การเอาชิ้นส่วนเหล่านี้มาประกอบให้ทำงานเป็นหนึ่งเดียวคือ “advanced packaging” และเทคนิคที่ดังที่สุดของ TSMC ชื่อ CoWoS — ไม่ว่าก้อนคำนวณตรงกลางจะเป็น GPU หรือชิปสั่งทำ (ASIC) ของยักษ์เทค ก็ต้องผ่านการประกอบแบบนี้เหมือนกัน
ในแผนผังเมกะเทรนด์ node นี้เป็นสาขาย่อย (leaf) ภายใต้ AI Compute & Accelerator Silicon ในเทรนด์ใหญ่ Artificial Intelligence ถ้าพี่น้องของมันอย่าง GPU และ HBM คือ “ชิ้นส่วน” node นี้คือ คนที่สร้างชิ้นส่วนนั้นขึ้นมาและประกอบมันเข้าด้วยกัน — เป็นด่านสุดท้ายก่อนชิป AI หนึ่งตัวจะออกจากโรงงาน
Foundry = โรงงานรับจ้างผลิตชิป สร้างทรานซิสเตอร์ลงบนแผ่นเวเฟอร์ตามแบบที่ลูกค้าออกแบบมา (TSMC คือเบอร์หนึ่ง) · Advanced packaging = การประกอบชิปหลายชิ้นเข้าเป็นแพ็กเกจเดียว แทนที่จะใส่ทีละชิ้น เพื่อให้ชิ้นส่วนอยู่ใกล้กันและสื่อสารกันได้เร็วขึ้น · CoWoS (Chip-on-Wafer-on-Substrate) = เทคนิค advanced packaging ของ TSMC ที่วาง GPU กับ HBM ลงบนแผ่นซิลิคอนตัวกลาง (interposer) แล้วประกอบเป็นชิป AI หนึ่งตัว
02ทำไมถึงสำคัญ — CoWoS คือคอขวดจริงของบูม AI
มีความเข้าใจผิดที่พบบ่อย: คนคิดว่าถ้าอยากได้ชิป AI มากขึ้น ก็แค่ให้ NVIDIA ออกแบบเพิ่ม แต่ความจริงคือ NVIDIA ออกแบบได้ไม่อั้น สิ่งที่ทำไม่ทันคือการ “สร้าง” และ “ประกอบ” มันต่างหาก และจุดที่ติดที่สุดไม่ใช่การผลิตทรานซิสเตอร์ (TSMC ทำได้ค่อนข้างทัน) แต่คือ การประกอบขั้นสุดท้าย — CoWoS
เหตุผลคือ ชิป AI หนึ่งตัวต้องเอา GPU มาวางคู่กับ HBM หลายแท่งบนแผ่น interposer ขนาดใหญ่กว่าปกติหลายเท่า งานนี้ละเอียดและช้า ผลิตได้น้อยต่อเดือน TSMC จึงเป็น “ก๊อกน้ำตัวจริง” — ปลายปี 2024 TSMC ผลิต CoWoS ได้ราว 35,000 แผ่นเวเฟอร์ต่อเดือน เร่งเป็น ~75,000 แผ่น/เดือนปลายปี 2025 และตั้งเป้า ~125,000–130,000 แผ่น/เดือนปลายปี 2026 — โตเกือบ 4 เท่าในไม่ถึงสองปี แต่ ยังไม่พอ ผู้บริหาร TSMC บอกเองว่ากำลังการผลิต CoWoS “ตึงมากและถูกจองหมดยาวถึงปี 2026” ส่วนโรงประกอบขั้นสูงทั้งหมดถูกจองยาวถึงปี 2027 ระยะเวลารอคิวยาว 52–78 สัปดาห์
ที่สำคัญไม่แพ้กันคือ การผลิตล้ำสุดกระจุกอยู่ที่บริษัทเดียว ในปี 2026 TSMC คุมตลาดการผลิตชิประดับล้ำสุด (advanced node) ที่ชิป AI ต้องใช้ มากกว่า 90% — แปลว่าชิป AI ระดับท็อปเกือบทุกตัวในโลก ไม่ว่าจะของ NVIDIA, AMD, Google หรือ Amazon ล้วนถูกผลิตที่ TSMC คนเดียว และเพราะ AI ดูดกำลังผลิตล้ำสุดเข้ามามหาศาล รายได้จากกลุ่มประมวลผลสมรรถนะสูง (HPC ซึ่งรวมชิป AI) จึงพุ่งขึ้นเป็น 58% ของรายได้ทั้งหมดของ TSMC ในปี 2025 และจะทะลุ 60% ในปี 2026
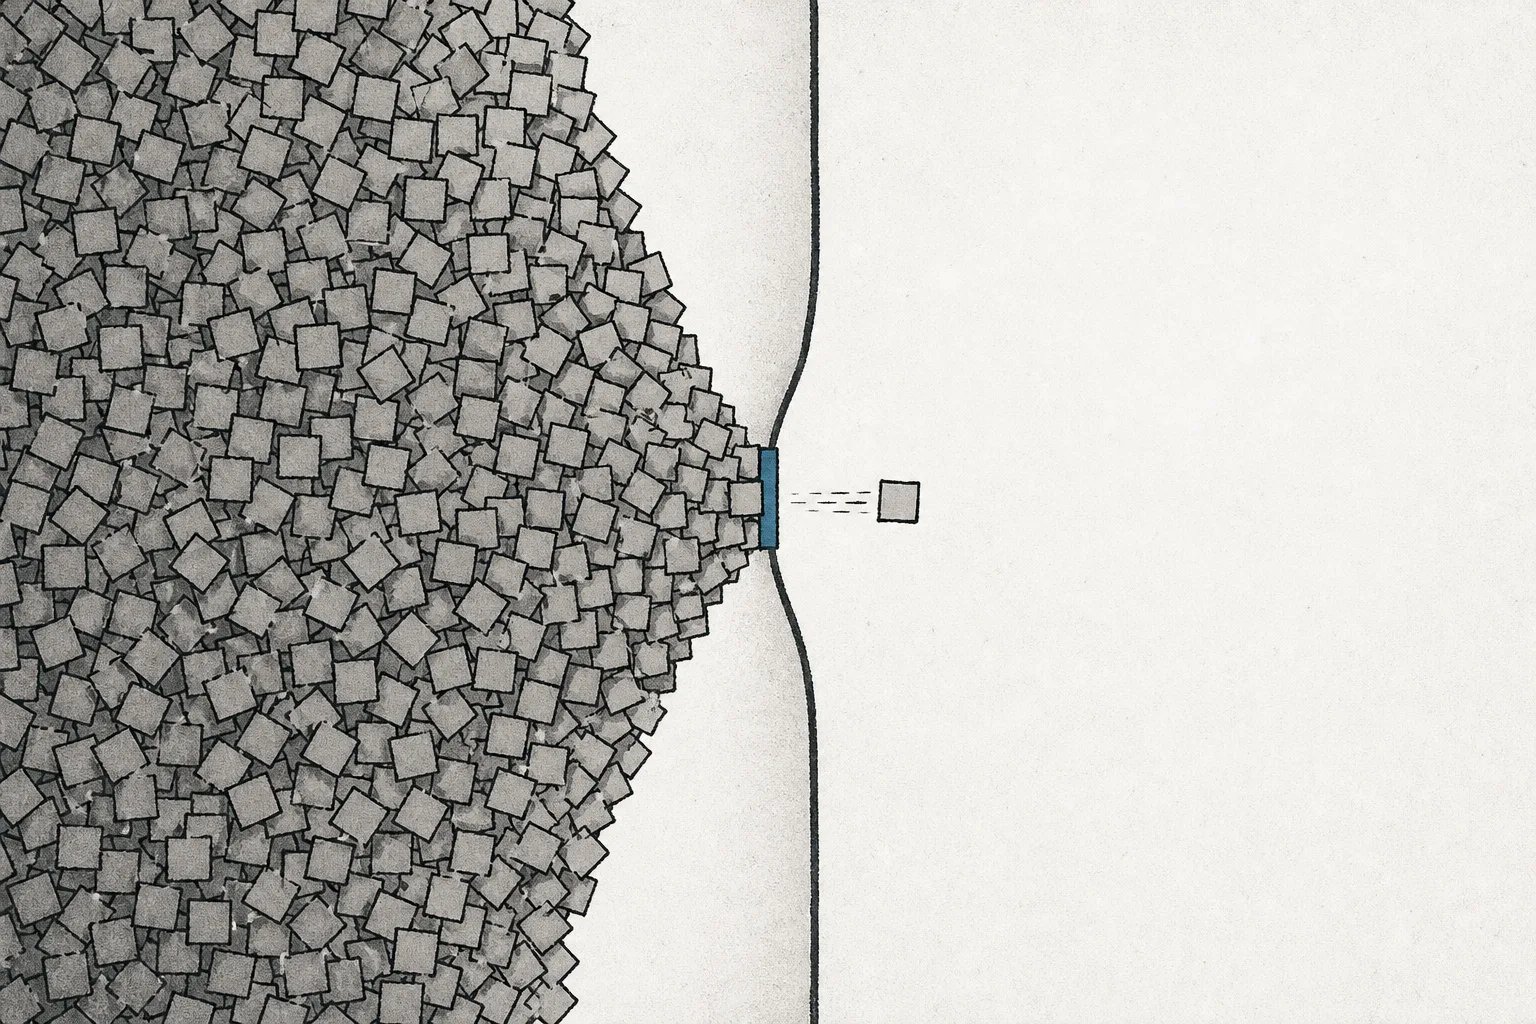
นี่คือเหตุผลที่ node นี้สำคัญแบบเงียบๆ แต่ทรงพลัง: ใครก็ตามที่อยากเข้าใจว่าทำไมชิป AI ถึง “ขาดตลาด” ทั้งที่ดีมานด์ล้น ต้องมองมาที่ชั้นนี้ — เพราะคอขวดอยู่ที่ กำลังการสร้างและประกอบ ไม่ใช่ที่ไอเดียหรือดีไซน์
03มันทำงานยังไง — จาก GPU + HBM สู่แพ็กเกจเดียว
หัวใจของ advanced packaging คือคำถามง่ายๆ: ทำยังไงให้ GPU กับหน่วยความจำ HBM อยู่ ชิดกันที่สุด เพราะยิ่งใกล้ ข้อมูลยิ่งวิ่งเร็วและประหยัดไฟ ถ้าเอา HBM ไปวางไกลๆ บนแผงวงจร (PCB) เหมือนคอมพิวเตอร์ทั่วไป แบนด์วิดท์จะตกฮวบจน GPU ทำงานไม่เต็มที่ คำตอบของ TSMC คือ CoWoS — ลองไล่ดูทีละขั้นว่าชิป AI หนึ่งตัวประกอบขึ้นมายังไง
แผ่น interposer ตรงกลางคือพระเอกที่มองไม่เห็น มันคือซิลิคอนบางๆ ที่มีสายไฟความหนาแน่นสูงและรู “through-silicon via” (TSV) เจาะทะลุ ทำให้ GPU คุยกับ HBM ได้ที่ความเร็วระดับหลาย เทระบิตต่อวินาที — เร็วกว่าการต่อผ่านแผงวงจรปกติหลายเท่า ปัญหาคือ interposer ของชิป AI ใหญ่ขึ้นเรื่อยๆ (เกินขนาดเวเฟอร์มาตรฐานหลายเท่า) ยิ่งใหญ่ยิ่งทำยาก ยิ่งเสียง่าย — นี่คือเหตุผลทางเทคนิคที่ทำให้ CoWoS เป็นคอขวด
CoWoS เป็นการประกอบแบบ “2.5D” — วางชิ้นส่วนเรียงข้างกันบน interposer (ไม่ได้ซ้อนทับ) ส่วนขั้นถัดไปคือ 3D — เอาชิปมา ซ้อนทับ กันตรงๆ แล้วเชื่อมด้วยการ “เชื่อมไฮบริด” (hybrid bonding) ระดับอะตอม เทคนิค 3D ของ TSMC ชื่อ SoIC (System on Integrated Chips) ทำให้ชิ้นส่วนอยู่ใกล้กว่าเดิมอีก เพิ่มทั้งความเร็วและความหนาแน่น — เป็นทิศทางที่ชิป AI รุ่นใหม่กำลังมุ่งไป
04มันอยู่ตรงไหนในระบบนิเวศ
ถ้ามองชั้นชิป AI ทั้งหมดเป็นสายการผลิต node นี้คือ ปลายทางที่ทุกชิ้นส่วนมาบรรจบ — เป็นด่านที่ดีไซน์กลายเป็นของจริง มันเชื่อมกับเพื่อนบ้านอย่างแยกไม่ออก
- ประกอบ GPU เข้ากับ HBM: สองชิ้นนี้คือวัตถุดิบหลักที่ CoWoS เอามาประกอบ ถ้าขาดอย่างใดอย่างหนึ่ง — GPU ขาด หรือ HBM ขาด — สายการประกอบก็หยุด คอขวด CoWoS, คอขวด HBM และคอขวด GPU จึงเป็นเรื่องเดียวกันที่พันกันอยู่
- คือมุม AI ของ Foundry และ Advanced Packaging: งานผลิตและประกอบในวงการชิปมีลูกค้าหลายแบบ แต่ AI คือลูกค้าที่โตเร็วและจ่ายแพงที่สุดตอนนี้ จน HPC กลายเป็น 58% ของรายได้ TSMC — node นี้คือ “สาขา AI” ของสองเรื่องนั้นในเทรนด์ Semiconductors
- ดูดพลังจาก Energy Transition & Power: โรงงาน foundry และ packaging กินไฟและน้ำมหาศาล การขยายกำลังผลิตจึงผูกกับความพร้อมของโครงข่ายไฟฟ้าในแต่ละพื้นที่โดยตรง
- พึ่ง Critical Materials & Supply Chain: การประกอบขั้นสูงต้องใช้ซับสเตรตคุณภาพสูง สารเคมีพิเศษ และวัสดุหายาก — node นี้จึงอ่อนไหวต่อความตึงเครียดของห่วงโซ่วัตถุดิบโลก
05ตอนนี้ไปถึงไหนแล้ว (2025–2026)
ภาพปัจจุบันสรุปได้ประโยคเดียว: TSMC ครองทั้งการผลิตและการประกอบชิป AI ระดับล้ำสุดแบบเกือบเบ็ดเสร็จ ปลายปี 2025 TSMC เริ่มผลิตชิประดับ 2 นาโนเมตร (2nm) เป็นจำนวนมากด้วยอัตราผลิตที่ดี และเร่งกำลังการประกอบ CoWoS ขึ้นต่อเนื่อง โดยลูกค้ารายใหญ่สุดคือ NVIDIA ที่จองกำลังการประกอบ CoWoS-L ของปี 2025 ไปแล้วกว่า 70% เพื่อป้อนชิป Blackwell ที่เหลือแบ่งกันระหว่าง AMD, Broadcom, Marvell และอื่นๆ
คู่แข่งกำลังพยายามไล่ แต่ยังตามอยู่ห่างพอควร Intel กับโรงงาน foundry ของตัวเองดันชิป 18A ให้อัตราผลิตขึ้นมาเกิน 60% แล้ว และเริ่มได้ลูกค้านอกบริษัทบ้าง ส่วน Samsung ที่เป็นเบอร์สองในการผลิตล้ำสุดมานาน กลับสะดุดเรื่องอัตราผลิตของชิป 2nm (เชื่อกันว่ายังต่ำกว่า 40%) — ช่องว่างระหว่างที่หนึ่งกับที่สองในการผลิตชิป AI จึงยังกว้าง
ด้านการประกอบ นอกจาก TSMC ที่ทำ CoWoS เองแล้ว ยังมีกลุ่มโรงงานรับจ้างประกอบและทดสอบที่เรียกว่า OSAT ซึ่งกินส่วนแบ่งตลาด advanced packaging ราว 59% ในปี 2025 นำโดย ASE (เบอร์หนึ่งของโลก) และ Amkor (เบอร์สอง ส่วนแบ่งราว 15% รายได้ราว $6,300 ล้านในปี 2024) — ทั้งคู่รับงานประกอบที่ TSMC ทำไม่ทันหรือไม่ได้ทำเอง และกำลังขยายกำลังการประกอบขั้นสูงเพื่อรับคลื่น AI
06อนาคตข้างหน้า
ทิศทางแรกคือ เร่งขยายกำลังการประกอบให้สุดกำลัง ตราบใดที่ CoWoS ยังเป็นคอขวด TSMC และคู่แข่งจะทุ่มเงินสร้างโรงประกอบใหม่ต่อเนื่อง — เป้าหมาย ~125,000–130,000 แผ่น/เดือนปลายปี 2026 คือการโตเกือบ 4 เท่าในสองปี นี่คือ ลมหนุนเชิงโครงสร้าง ของ node นี้: ตราบใดที่ดีมานด์ชิป AI ยังล้น กำลังการประกอบที่เพิ่มเท่าไรก็ถูกจองหมดเท่านั้น
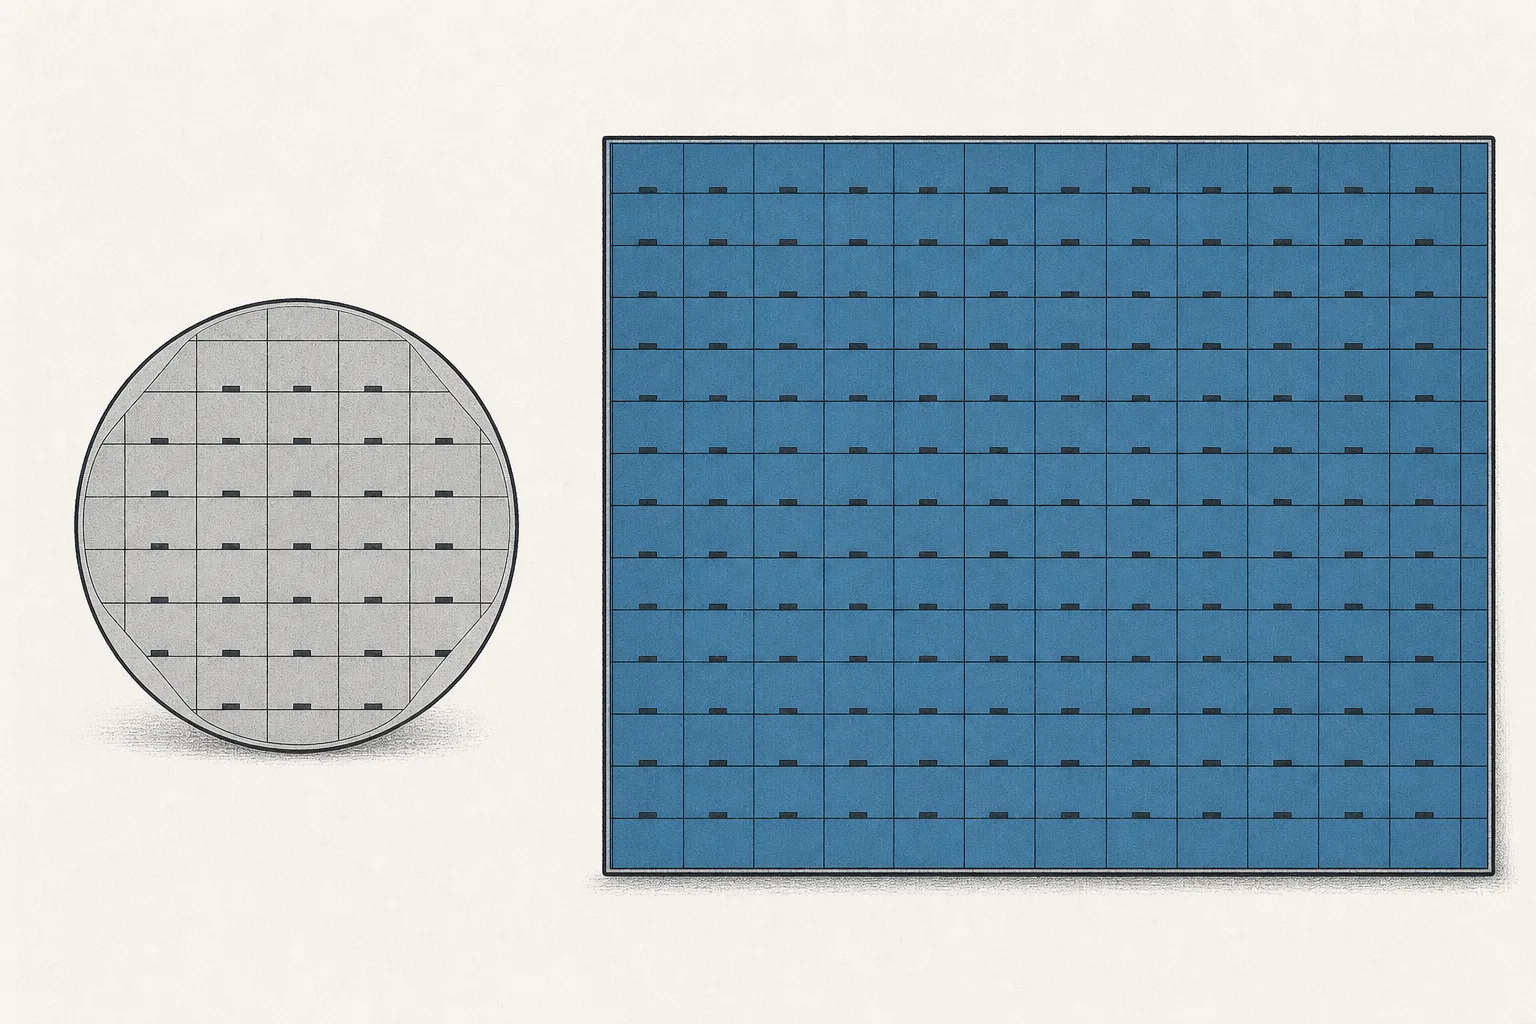
ทิศทางที่สองคือ เปลี่ยนจากเวเฟอร์กลมเป็นแผ่นสี่เหลี่ยม (panel-level packaging) ปัจจุบันการประกอบทำบนเวเฟอร์ทรงกลม ซึ่งเหลือขอบทิ้งเยอะและจำกัดขนาด อนาคตวงการกำลังย้ายไปประกอบบนแผ่นสี่เหลี่ยมขนาดใหญ่ (เหมือนจอแสดงผล) เพื่อประกอบได้มากชิ้นต่อรอบและรองรับชิป AI ที่ใหญ่ขึ้น — แต่ต้องลงทุนสายการผลิตใหม่ที่แพงกว่า $500 ล้านต่อสาย
ทิศทางที่สามคือ วัสดุใหม่ — ซับสเตรตแก้ว (glass substrate) และการเชื่อมแบบ 3D ซับสเตรตแก้วเรียบและทนความร้อนกว่าวัสดุเดิม ช่วยให้ประกอบชิปขนาดใหญ่ได้แม่นขึ้น ส่วนการซ้อนชิปแบบ 3D (SoIC, hybrid bonding) จะทำให้ GPU กับหน่วยความจำอยู่ใกล้กันยิ่งกว่าเดิม — ทั้งสองอย่างคือ “เจเนอเรชันถัดไป” ของการประกอบที่จะนิยามชิป AI ในอีกไม่กี่ปีข้างหน้า
07ความท้าทายและความเสี่ยง
ความเสี่ยงข้อแรกคือ การกระจุกตัวที่ไต้หวัน เมื่อชิป AI ระดับล้ำสุดกว่า 90% ถูกผลิตและประกอบโดย TSMC ซึ่งฐานการผลิตหลักอยู่ที่ไต้หวัน ความเสี่ยงทางภูมิรัฐศาสตร์และภัยธรรมชาติจึงไม่ใช่เรื่องไกลตัว ถ้าจุดเดียวนี้สะดุด ทั้งห่วงโซ่ชิป AI ของโลกสะเทือนทันที TSMC พยายามกระจายความเสี่ยงด้วยการสร้างโรงงานในสหรัฐฯ (ลงทุนรวมสูงถึง $165,000 ล้านที่รัฐแอริโซนา) แต่การย้ายกำลังการประกอบขั้นสูงตามไปด้วยใช้เวลาหลายปี
ความเสี่ยงข้อสองคือ คอขวดการประกอบที่แก้ไม่ทันดีมานด์ แม้ TSMC จะเร่งขยาย CoWoS เกือบ 4 เท่า นักวิเคราะห์หลายสำนักยังมองว่าอาจ ไม่พอ กับดีมานด์ที่โตเร็วกว่า ผลคือชิป AI ขาดตลาดต่อเนื่อง ราคาแพง และลูกค้ารายเล็กเข้าคิวไม่ทันรายใหญ่ — คอขวดนี้กลายเป็นตัวกำหนดว่าใครได้ชิป AI ก่อนใคร
ความเสี่ยงข้อสามคือ การพึ่งลูกค้าและคู่ค้าไม่กี่ราย เมื่อ NVIDIA จองกำลังการประกอบไปกว่า 70% รายได้ของชั้นนี้จึงผูกกับการลงทุน AI ของลูกค้ากระเป๋าหนักไม่กี่ราย ถ้าการลงทุน AI ชะลอตัว หรือดีมานด์ที่ดูไม่มีวันเต็มเริ่มอิ่ม กำลังการประกอบที่เพิ่งสร้างมาด้วยเงินมหาศาลก็อาจเหลือเกินในชั่วข้ามคืน — เป็นธุรกิจกำไรดีแต่ผูกกับวัฏจักรการลงทุนที่ผันผวน
สรุปสั้นๆ: node นี้คือคำตอบของคำถามที่หลายคนมองข้าม — “ใครสร้างชิป AI จริงๆ?” คำตอบไม่ใช่ NVIDIA แต่คือ TSMC และโรงประกอบไม่กี่แห่งที่เอา GPU กับ HBM มาประกอบเป็นชิ้นเดียว ตราบใดที่การประกอบ CoWoS ยังเป็นจุดที่ช้าและขาดที่สุด ชั้นนี้ก็คือคอขวดที่ทรงพลังที่สุดจุดหนึ่งของเศรษฐกิจ AI ทั้งใบ