Megatrend · Artificial Intelligence
โมเดลถูก “ฝึก” แค่ครั้งเดียว แต่ถูก “รัน” พันล้านครั้ง — และนี่คือชิปที่ออกแบบมาเพื่องานพันล้านครั้งนั้น
ชิป AI ที่โลกรู้จัก (GPU ของ NVIDIA) ถูกออกแบบมาเก่งเรื่อง “ฝึก” โมเดล แต่การฝึกเกิดขึ้นไม่กี่ครั้ง ส่วนการ “รัน” โมเดลให้ตอบคำถามจริง (inference) เกิดขึ้นทุกวินาที นับล้านนับพันล้านครั้ง พอปริมาณการรันใหญ่กว่าการฝึกหลายเท่า ต้นทุนต่อคำตอบ (cost per token) กับความเร็ว (tokens ต่อวินาที) จึงกลายเป็นสมรภูมิใหม่ — และเปิดทางให้ชิปสายพันธุ์ใหม่ที่ทำ “เฉพาะการรัน” ให้เร็วและถูกกว่า GPU ทั่วไป บทเรียนนี้พาไปรู้จัก Groq, Cerebras, d-Matrix และเหตุผลที่ผู้เล่นตัวจริงส่วนใหญ่ยังเป็นบริษัทเอกชน
01มันคืออะไร — ชิปที่เอาไว้ “รัน” ไม่ใช่ “เทรน”
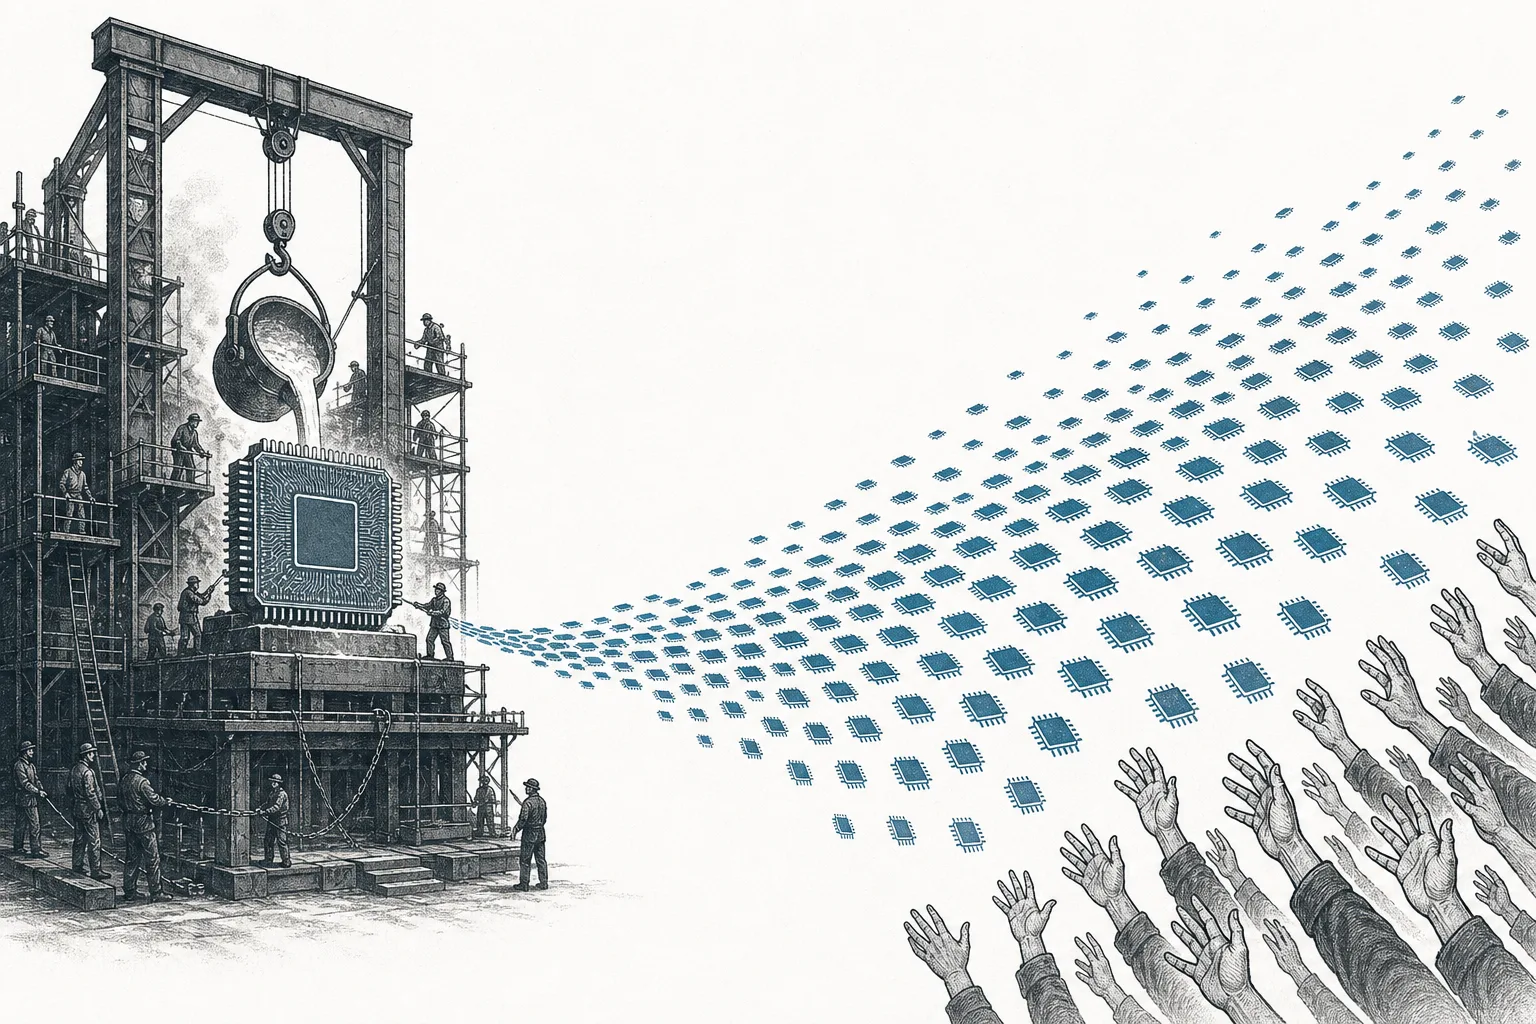
ลองนึกถึงการสร้างหนังสือพจนานุกรมสักเล่ม การ เขียนและเรียบเรียง พจนานุกรมขึ้นมาใช้เวลาเป็นปีและทีมงานมหาศาล — แต่ทำแค่ครั้งเดียว หลังจากนั้นสิ่งที่เกิดขึ้นทุกวันคือคน เปิดหาคำ นับล้านครั้ง โลกของ AI ก็เหมือนกันเป๊ะ การ “ฝึก” (training) โมเดลคือการเขียนพจนานุกรม ส่วนการ “รัน” (inference) คือการเปิดหาคำ — และ node นี้คือเรื่องของชิปที่ออกแบบมาเพื่อ “การเปิดหาคำ” โดยเฉพาะ ไม่ใช่การเขียน
ในแผนผังเมกะเทรนด์ node นี้เป็นสาขาย่อย (leaf) ภายใต้ AI Compute & Accelerator Silicon ในเทรนด์ใหญ่ Artificial Intelligence นิยามของมันตรงไปตรงมา: “สถาปัตยกรรมที่ออกแบบมาเพื่อการรันโมเดลที่หน่วงต่ำ (low-latency) และไหลเร็ว (high-throughput)” พูดภาษาคนคือ — ชิปที่ทำให้ AI ตอบเร็วและตอบถูกๆ ในราคาต่อคำตอบที่ถูกที่สุด
ทำไมต้องมีชิปแยกสำหรับงานนี้? เพราะ “การรัน” กับ “การฝึก” เป็นงานคนละแบบ การฝึกต้องคำนวณย้อนกลับ-ปรับค่าน้ำหนักนับล้านล้านครั้ง ต้องการความยืดหยุ่นและพลังดิบมหาศาล ส่วนการรันคือการคำนวณไปข้างหน้าทางเดียว ทำซ้ำแบบเดิมๆ คาดเดาได้ — งานที่ “รู้ล่วงหน้าว่าจะทำอะไร” แบบนี้ ออกแบบชิปเฉพาะทางให้ทำได้เร็วและประหยัดไฟกว่าชิปอเนกประสงค์มาก นี่คือเหตุผลที่ชิปสายพันธุ์ใหม่อย่าง LPU ของ Groq หรือเครื่องระดับเวเฟอร์ของ Cerebras ถึงเกิดขึ้นมา
Training (การฝึก) = สอนโมเดลด้วยข้อมูลมหาศาล เกิดขึ้นครั้งเดียว/นานๆ ครั้ง · Inference (การรัน) = เอาโมเดลที่ฝึกเสร็จแล้วมาตอบคำถามจริง เกิดขึ้นตลอดเวลา · Token = หน่วยข้อความเล็กๆ (ราวคำหรือเศษคำ) ที่โมเดลผลิตทีละชิ้น คำตอบหนึ่งย่อหน้าอาจเป็นร้อย token · Latency (ความหน่วง) = เวลาที่รอกว่าจะได้คำตอบ — ยิ่งต่ำยิ่งรู้สึก “ทันใจ”
02ทำไมถึงสำคัญ — เมื่อ “การรัน” ใหญ่กว่า “การฝึก”
เรื่องที่เปลี่ยนทุกอย่างคือ สัดส่วนของคอมพิวต์กำลังพลิก ในปี 2023 การฝึกโมเดลกินคอมพิวต์ราวสองในสาม การรันกินแค่หนึ่งในสาม แต่พอ AI ออกจากห้องทดลองไปสู่การใช้งานจริงระดับล้านคน ทุกอย่างก็กลับด้าน — ปี 2025 การรันขึ้นมาเป็นราว ครึ่งหนึ่ง และปี 2026 คาดว่าจะขึ้นเป็น สองในสาม ของคอมพิวต์ AI ทั้งหมด หลายสำนักมองว่าภายในปี 2028–2030 การรันจะกินถึง 70–80%
พอการรันกลายเป็นก้อนใหญ่ ตลาดของชิปที่ทำงานนี้ก็พองตามมหาศาล หลายสำนักประเมินตลาดชิป inference ต่างกันตามขอบเขตที่นับ แต่ทิศทางตรงกัน: Deloitte มองว่าเฉพาะชิปที่ออกแบบมาเพื่อ inference จะทะลุ $50,000 ล้าน ในปี 2026 ส่วนภาพตลาดชิป inference แบบกว้างอยู่ที่ราว $105,000 ล้าน ในปี 2025 และหลายสำนักมองว่าจะโตไปแตะ $300,000–570,000 ล้าน ในช่วงต้นทศวรรษ 2030 ที่อัตราโตเฉลี่ยราว 25–28% ต่อปี
ที่สำคัญกว่าขนาดคือ เศรษฐศาสตร์ของมันต่างจากการฝึกสิ้นเชิง ตอนฝึก คุณยอมจ่ายแพงครั้งเดียวเพื่อให้ได้โมเดลที่ดี แต่ตอนรัน คุณต้องจ่ายซ้ำ ทุกครั้งที่มีคนถาม ฉะนั้นถ้าลดต้นทุนต่อคำตอบลงได้แม้แต่นิดเดียว เมื่อคูณด้วยพันล้านครั้ง มันคือเงินมหาศาล — และนั่นคือเหตุผลทั้งหมดที่ชิปกลุ่มนี้มีตัวตน: ไม่ใช่เพื่อทำงานเก่งสารพัด แต่เพื่อทำงานเดียวให้ เร็วที่สุดและถูกที่สุดต่อ token
03มันทำงานยังไง — ฝึกครั้งเดียว แล้วรันไม่รู้จบ
หัวใจของ node นี้อยู่ที่ความ ไม่สมมาตร ระหว่างการฝึกกับการรัน ลองไล่ดูเส้นทางชีวิตของโมเดลหนึ่งตัวว่าทำไม “การรัน” ถึงกลายเป็นต้นทุนก้อนใหญ่ที่ชี้ขาดทุกอย่าง
แล้วชิป inference ทำให้เร็วขึ้นได้ยังไง? กุญแจอยู่ที่ หน่วยความจำ เวลารันโมเดล ตัวคูณเลขไม่ใช่คอขวด — การ ขนค่าน้ำหนัก ของโมเดลจากหน่วยความจำมาป้อนชิปต่างหากที่ช้า GPU ทั่วไปเก็บน้ำหนักไว้ในหน่วยความจำ HBM ที่อยู่ “นอกชิป” ส่งข้อมูลได้ราว 8 TB/s ขณะที่ Groq เลือกออกแบบให้เก็บน้ำหนักไว้ใน SRAM บนตัวชิปเลย ซึ่งเร็วระดับ 80 TB/s ขึ้นไป — เร็วกว่าสิบเท่า ผลคือชิปไม่ต้องรอข้อมูล จึงพ่น token ออกมาได้รัวกว่ามาก
HBM = หน่วยความจำแบนด์วิดท์สูงที่วางข้างชิป จุได้เยอะแต่เข้าถึงช้ากว่า (ดู HBM & AI Memory) · SRAM = หน่วยความจำที่ฝังบนตัวชิปเลย เร็วมากแต่จุได้น้อย ชิป inference บางตัวเลือกยอมแลกความจุเพื่อความเร็ว · Deterministic execution = การจัดคิวงานล่วงหน้าทุกจังหวะนาฬิกาตั้งแต่ตอนคอมไพล์ ทำให้ไม่มี “สะดุด” แบบสุ่ม — Groq ใช้วิธีนี้เพื่อรีดความเร็วและความแน่นอนออกมาให้สูงสุด
04มันต่างกับ GPU และ ASIC ยังไง — และเชื่อมกับอะไรบ้าง
node นี้มีพี่น้องอยู่ในตระกูลเดียวกันที่ต้องแยกให้ออก เพราะทั้งหมด “รัน” โมเดลได้เหมือนกัน แต่ปรัชญาต่างกัน:
- เทียบกับ GPU & Merchant Accelerators: GPU คือชิปอเนกประสงค์ที่ ฝึกก็ได้ รันก็ได้ จุดแข็งคือความยืดหยุ่นและซอฟต์แวร์ (CUDA) ที่นักพัฒนาทั้งโลกคุ้นเคย แต่ความยืดหยุ่นนั้นมาพร้อมส่วนเกินที่ไม่จำเป็นเวลารัน — ชิป inference เฉพาะทางตัดส่วนเกินนั้นทิ้ง เพื่อแลกกับความเร็ว/ราคาต่อ token ที่ดีกว่าในงานรันล้วนๆ
- เทียบกับ Custom Silicon / ASIC: เส้นแบ่งบางมาก — ชิป inference เฉพาะทางก็คือ ASIC ชนิดหนึ่ง ความต่างคือ “ใครสร้างและเพื่ออะไร” node 10010200 เน้น ASIC ที่ ยักษ์เทคสร้างเอง เพื่อใช้ในคลาวด์ตัวเอง (เช่น TPU ของ Google) ส่วน node นี้เน้นชิป inference ที่ บริษัทชิปอิสระ สร้างมาขาย/ให้บริการแก่ทุกคน (Groq, Cerebras, d-Matrix)
- พึ่ง HBM & AI Memory และ Foundry & Contract Fabrication: ไม่ว่าจะเลือกใช้ SRAM หรือ HBM ชิปเหล่านี้ก็ยังต้องถูกผลิตด้วยกระบวนการล้ำสุดและแพ็กเกจขั้นสูงเหมือนชิป AI ตัวอื่น
เมื่อมองออกไปนอกตระกูลชิป node นี้คือ “เครื่องยนต์” ที่จุดเทรนด์อื่นให้ติด:
- ป้อนพลังให้ Agentic AI โดยตรง: AI ตัวแทน (agent) ที่ทำงานเป็นขั้นๆ ต้องเรียกโมเดลซ้ำหลายรอบต่อหนึ่งงาน — แต่ละรอบคือการรันใหม่ ยิ่ง agent แพร่หลาย ดีมานด์ inference ยิ่งทวีคูณ นี่คือลูกค้าที่หิวความเร็วและต้นทุนต่ำที่สุด
- เป็นคู่หูของ Semiconductors (Logic): ชิป inference คือชิปลอจิกที่ออกแบบเพื่องาน AI โดยเฉพาะ — มอง node นี้ผ่าน “เลนส์ดีมานด์ AI” ขณะที่ Logic มองผ่านเลนส์เทคโนโลยีการผลิตชิปทั้งวงการ สองมุมของของชิ้นเดียวกัน
- ดูดไฟจาก Energy Transition & Power Demand และพึ่ง Cloud & Digital Infrastructure: การรันที่เกิดขึ้นทุกวินาทีกินไฟต่อเนื่อง (ต่างจากการฝึกที่จบเป็นรอบ) ประสิทธิภาพต่อวัตต์จึงเป็นจุดขายหลักของชิปกลุ่มนี้ และยัง “enables” ทั้ง Robotics และ Biotech ที่ต้องการ AI ตอบเร็ว
05ตอนนี้ไปถึงไหนแล้ว (2025–2026)
สนามนี้กำลังร้อนแรงและมีเรื่องน่าทึ่งสองชั้น ชั้นแรกคือ ตัวเลขความเร็วที่ฉีกกราฟ ชิปเฉพาะทางรัน LLM ได้เร็วกว่า GPU เดี่ยวแบบไม่เห็นฝุ่น — Groq ทำได้ราว 300–750 token ต่อวินาที เทียบกับ GPU ทั่วไปราว 100 ส่วน Cerebras บนเครื่องระดับเวเฟอร์ทำได้กว่า 2,500 token ต่อวินาที ต่อผู้ใช้บนโมเดล Llama รุ่นใหญ่ และ d-Matrix อ้างว่าแพลตฟอร์มของตนรันได้เร็วกว่า เสียค่าใช้จ่ายต่ำกว่า และประหยัดไฟกว่าระบบ GPU หลายเท่า
ชั้นที่สองคือ ผู้เล่นตัวจริงส่วนใหญ่ยังเป็นบริษัทเอกชน — Groq, SambaNova และ d-Matrix ยังไม่จดทะเบียนในตลาดหุ้น ทำให้นักลงทุนรายย่อยซื้อตรงไม่ได้ d-Matrix เพิ่งระดมทุนรอบ Series C ได้ $275 ล้าน ปลายปี 2025 ที่มูลค่ากิจการ $2,000 ล้าน ส่วน Cerebras ผู้บุกเบิกชิประดับเวเฟอร์ คือรายแรกๆ ที่ก้าวเข้าตลาดหุ้น โดยมีรายได้ปี 2025 ราว $510 ล้าน โต 76% หนุนด้วยสัญญาซื้อคอมพิวต์มูลค่ากว่า $20,000 ล้านจาก OpenAI
อีกด้านหนึ่ง เจ้าตลาดอย่าง NVIDIA และ AMD ไม่ได้ยืนดูเฉยๆ ทั้งคู่ออกชิป/รุ่นที่จูนมาเพื่อ inference โดยเฉพาะ — NVIDIA เปิดตัว Rubin CPX ที่ออกแบบสำหรับงานรันบริบทยาวขนาดใหญ่ (คาดวางตลาดปลายปี 2026) ส่วน AMD ผลักดันตระกูล Instinct (MI350/MI400) เป็นทางเลือกด้านต้นทุนต่อการคำนวณ และได้ OpenAI เป็นพันธมิตรเชิงกลยุทธ์ ฉะนั้นสนาม inference จึงไม่ใช่แค่ “สตาร์ทอัพ vs ยักษ์” แต่เป็นการแข่งกันบนแกน ความเร็ว–ต้นทุน–ความยืดหยุ่น ที่ทุกฝ่ายลงมาเล่น
06อนาคต — ยุคโมเดลที่ “คิดเยอะ”
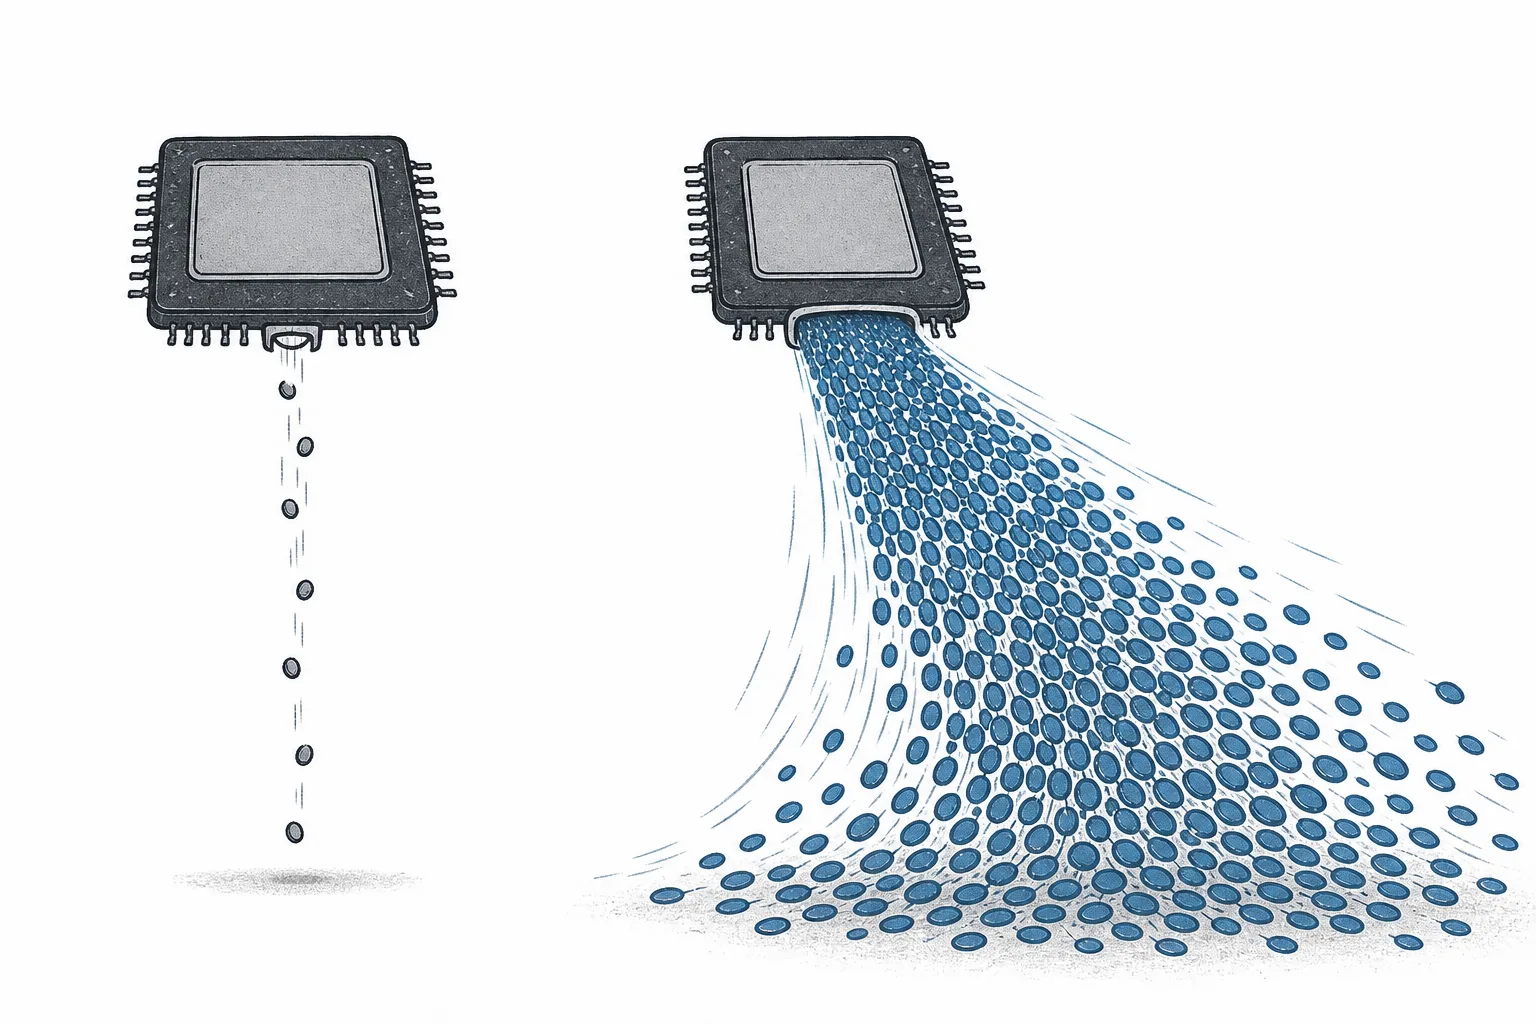
ลมหนุนที่ใหญ่ที่สุดของ node นี้คือ โมเดลแบบใช้เหตุผล (reasoning models) โมเดลรุ่นใหม่ไม่ได้ตอบทันที แต่ “คิดในใจ” เป็นขั้นๆ ก่อนตอบ — และการคิดในใจนั้นคือการผลิต token จำนวนมหาศาลที่ผู้ใช้มองไม่เห็น ผลคือคำถามหนึ่งข้ออาจกินคอมพิวต์ในขั้นรันมากกว่าโมเดลรุ่นก่อนถึง 5–10 เท่า (บางงานหนักถึงระดับ 70–100 เท่าในแง่พลังงาน) ดีมานด์ inference จึงไม่ได้โตแค่ตามจำนวนผู้ใช้ แต่โตตาม “จำนวน token ต่อคำถาม” ที่พุ่งขึ้นด้วย
ที่ดูเหมือนขัดกันแต่จริงๆ เสริมกันคือ ราคาต่อ token กำลังถูกลงเร็วมาก ต้นทุนการรันโมเดลระดับ GPT-3.5 ลดลงกว่า 280 เท่าในช่วงปลายปี 2022 ถึงปลายปี 2024 — แต่ยิ่งถูก คนยิ่งใช้เยอะ และโมเดลยิ่งคิดเยอะ จน ยอดการใช้รวมโตเร็วกว่าราคาที่ลดลง นี่คือ “ความขัดแย้งของต้นทุน AI” ที่ทำให้บิลค่าคอมพิวต์ของบริษัท AI ยังบานปลายแม้ราคาต่อหน่วยจะถูกลง — และเป็นเหตุผลที่ทุกคนวิ่งหาชิปที่รันได้ถูกที่สุด
ทิศทางที่สองคือ การรันจะกระจายตัว ไม่ใช่ทุกงานต้องวิ่งในศูนย์ข้อมูลยักษ์ — งาน inference เริ่มเลื่อนบางส่วนไปอยู่ใกล้ผู้ใช้มากขึ้น (ดู Edge & On-device AI Silicon) เพื่อความหน่วงต่ำและความเป็นส่วนตัว เปิดช่องให้สถาปัตยกรรมที่ประหยัดไฟเป็นพิเศษเข้ามาเล่นในที่ที่ GPU ตัวใหญ่ไปไม่ถึง
07ความท้าทายและความเสี่ยง
ความเสี่ยงข้อแรกคือ เจ้าตลาดก็ลงมาเล่นในสนามรันด้วย หลายคนเข้าใจว่า inference เป็น “ช่องโหว่” ของ NVIDIA แต่ความจริงคือ NVIDIA ครองงาน inference อยู่แล้วเป็นส่วนใหญ่ และยังออกชิปจูนเฉพาะ (เช่น Rubin CPX) มาป้องกันพื้นที่ตัวเอง ขณะที่ AMD ก็ไล่ตามด้วยต้นทุนรวมที่ดึงดูด — สตาร์ทอัพชิป inference จึงต้องเร็วและถูกกว่ามากพอที่จะคุ้มกับการ “ออกจากระบบนิเวศซอฟต์แวร์” ที่คุ้นเคย ซึ่งเป็นกำแพงที่ข้ามยากกว่าตัวเลขความเร็วบนสไลด์
ความเสี่ยงข้อสองคือ ผู้เล่นเด่นส่วนใหญ่ยังเป็นบริษัทเอกชน Groq, SambaNova และ d-Matrix ยังไม่อยู่ในตลาดหุ้น นักลงทุนทั่วไปจึงเข้าถึงโดยตรงได้ยาก และในฐานะบริษัทอายุน้อยที่ยังเผาเงินเพื่อสร้างฐานลูกค้า เส้นทางสู่กำไรของพวกเขายังต้องพิสูจน์ — บางรายอาจถูกซื้อกิจการ บางรายอาจไม่รอด นี่เป็นสนามที่ “เทคโนโลยีเจ๋ง” ไม่การันตี “ธุรกิจรอด”
ความเสี่ยงข้อสามคือ การพึ่งลูกค้าไม่กี่ราย และคำถามเรื่องวัฏจักร ดีมานด์ก้อนใหญ่ของชิป inference มาจากบริษัท AI และยักษ์คลาวด์ไม่กี่เจ้าที่ทุ่มลงทุนพร้อมกัน (เช่นสัญญายักษ์ระหว่าง Cerebras กับ OpenAI) ถ้าผลตอบแทนจาก AI มาช้ากว่าคาดหรือการลงทุนชะลอ ดีมานด์ที่ดูไม่มีวันเต็มก็อาจหดเร็ว และเพราะลูกค้ากระจุกตัว การเสียดีลใหญ่เพียงรายเดียวก็สะเทือนทั้งบริษัทได้
สรุปสั้นๆ: node นี้คือชิปที่เกิดมาเพื่องานที่ AI ทำบ่อยที่สุด — “การรัน” โมเดลให้ตอบคำถามจริงนับพันล้านครั้ง เมื่อการรันใหญ่ขึ้นเรื่อยๆ และโมเดลคิดเยอะขึ้นเรื่อยๆ ใครที่รันได้เร็วและถูกที่สุดต่อ token ก็จะถือกุญแจสำคัญดอกหนึ่งของเศรษฐกิจ AI ทั้งใบ